Mostrando entradas con la etiqueta Coherence. Mostrar todas las entradas

lunes, 3 de diciembre de 2012

Topologías de Oracle Coherence Parte 4


Near Cache

En el artículo anterior (Parte 3: Topologia Distribuida) se trató la topología de replicación en Oracle Coherence, se vio que es una buena topología para soportar una alta tasa de escrituras pero que el rendimiento en las lecturas se ve degradado.

En este nuevo artículo se tratará la topología “Near Cache” la cual es un hibrido entre la topología de replicación y la topología distribuida teniendo como consecuencia lo mejor de ambas topologías, un buen rendimiento para lecturas y un buen rendimiento para escrituras.

La topología Near cache se divide en dos capas:

  • Front Cache
  • Back Cache


El Front Cache no es más que un subconjunto de elementos en cada uno de los nodos de Coherence, los cuales son accedidos localmente para realizar las solicitudes de lectura. De esta manera se alcanza una latencia nula (ventaja de topología de replicación).

El Back Cache se encarga de recibir todas las solicitudes de escritura tal como se realiza en la topología distribuida. Por medio de una clave hash se localiza el nodo que aloja el objeto y se realiza la escritura en ese nodo.

Entonces, toda solicitud de escritura es enviada directamente al Back Cache y toda solicitud de lectura es realizada por el Front Cache. La capa que tiene los objetos verdaderos es la Capa distribuida (Back Cache), por lo tanto, el Front Cache no es más que una imagen de lo que se tiene en el Back Cache con el único objetivo de hacer las lecturas locales y alcanzar una latencia nula. Acá existe un problema, el Front Cache puede tener objetos “caducados”. Para solucionar este problema la topología Near Cache proporciona las siguientes formas de desalojar objetos en el Front Cache:

  • None
  • Present
  • All
  • Auto

Método de desalojo de objetos NONE: No desaloja los objetos en el Front Cache. En algunas aplicaciones no es tan importante que los objetos muestren información a la fecha, puede tolerarse cierto retraso en los datos. La ventaja de este método es que no implica ninguna carga adicional en la red para poder mantener los datos a la fecha. No existe comunicación para sincronización entre  Front Cache – Back Cache. Sin embargo, no siempre se puede querer tener los datos atrasados por siempre, entonces quizás se deba usar alguna estrategia de expiración basado en tiempo.

Metodo de desalojo de objetos PRESENT: Este método realiza el desalojo de los objetos por medio de “listeners” los cuales son los encargados de monitorear los cambios realizados en el Back Cache y sincronizarlos hacia el Front Cache. Se deben crear tantos listener como objetos se tengan en el Front Cache. Es decir, para cada objeto en el Front Cache se debe crear un listener. Cuando un objeto es modificado en el Back Cache el listener es el encargado de desalojar el objeto caducado en el Front Cache y situar la nueva imagen de dicho objeto, esta sincronización es realizada de manera asíncrona, de tal manera que entre la modificación del objeto en el Back Cache hasta la modificación del objeto en el Front Cache existe un tiempo mínimo en el que el objeto aun sigue estando caducado. Por lo común este tiempo mínimo es aceptado, sin embargo, si se desea necesariamente tener los objetos en el Front Cache totalmente a la fecha se puede incurrir explícitamente en un bloqueo del objeto mientras el listener actualiza la imagen en el Front Cache. Por supuesto que la sincronización entre el Back Cache y el Front Cache generará más tráfico en la red por lo que esta es una de las desventajas de esta topología.

Método de desalojo de objetos ALL: Este método es muy parecido al método PRESENT, la diferencia radica en que en el método PRESENT se tiene que crear un listener por cada objeto situado en el Front Cache, mientras que en el método ALL se crea un solo listener. La ventaja de esto es que el número de ciclos de CPU se reducirán debido a que solo hay un listener procesando información, la desventaja es que el tráfico en la red se aumentará y quizás hasta se vean encolamientos debido a que solo existe un listener atendiendo las notificaciones de cambios en los objetos situados en el Back Cache. Por lo regular los ambientes que tienen más alta tasa de lecturas que de escrituras y están utilizando la topología Near Cache se deciden utilizar el método de desalojo PRESENT, pero si al contrario, se tiene una tasa de escrituras más alta a la de lecturas suelen utilizar el método ALL  para desalojar objetos caducados.

Método de desalojo de objetos AUTO: Este método realiza cambios automáticamente entre el método PRESENT y el método ALL basándose en estadísticas de las transacciones realizadas en cada una de las capas (Front Cache y Back Cache). La estrategia default de la topología Near Cache es AUTO, sin embargo, este método no necesariamente realiza un adecuado cambio entre los métodos PRESENT Y ALL  pues se basa en sus propias estadísticas, por lo que se aconseja establecer el método de manera explícita entre el PRESENT Y ALL, o usar NONE si es aceptable que las aplicaciones muestren datos que no estén necesariamente a la fecha.


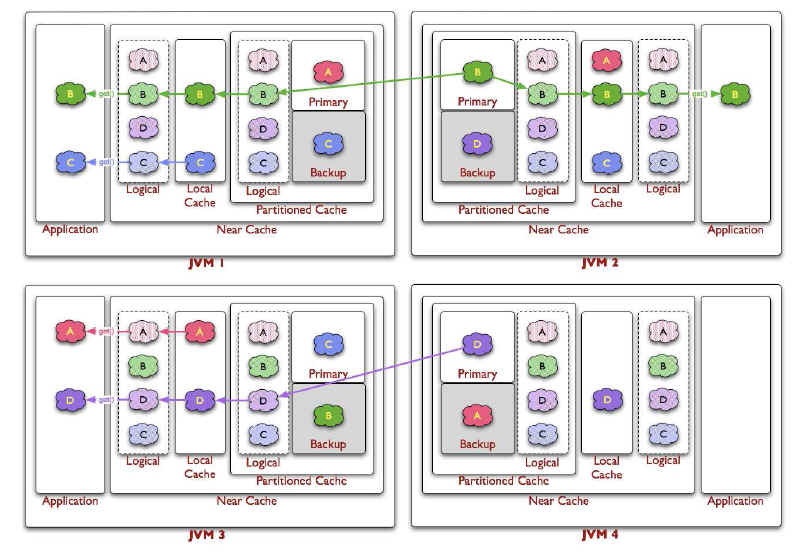
En la siguiente imagen se realiza una operación de escritura del objeto D desde el nodo 1 de Coherence, este objeto es delegado directamente al Back Cache, el cual a su vez localiza que el objeto está alojado en el nodo 4 y su respectivo backup es alojado en el nodo 3. El Back Cache realiza pues la escritura del objeto en el nodo 4 y su respectivo backup en el nodo 3.


En la siguiente imagen se realiza una operación de lectura del objeto B, esta operación es realizada por el Front Cache, el cual  sabe que tiene que ir a traer la imagen más reciente del  objeto pues se encuentra caducada, dicha imagen es traída desde el nodo 2. También se realiza una lectura del objeto C la cual se realiza de manera local logrando una latencia nula.

CONCLUSION: Esta topología contiene las ventajas que proporciona la tecnología distribuida y la tecnología replicada, sin embargo, la desventaja es que se debe incurrir en un procesamiento adicional que es dado por el método de desalojo que se utilice. Es necesario también realizar un análisis previo para poder determinar el método de desalojo, pues si se tiene un método de desalojo no adecuado puede tener como consecuencia un mal rendimiento u objetos no desalojados adecuadamente.

Hasta aqui doy por finalizado el articulo de Topologias de Oracle Coherence, a continuación un link de cada uno de las partes conforman el articulo:


Articulo Completo listo para descargarse en el siguiente link: https://www.dropbox.com/s/7dv1aom6u1lzqan/Topologias%20de%20Coherence.pdf

viernes, 12 de octubre de 2012

Topologías de Oracle Coherence Parte 1


Introducción a Oracle Coherence:

Oracle Coherence es un producto dentro de Fusion Middleware que permite crear redes de datos en memoria para agilizar las lecturas/escrituras de nuestros objetos, esto sin descuidar la confiabilidad, la accesibilidad y la seguridad de los datos. Coherence también es una solución escalable, la capacidad de memoria puede llegar a ser tan grande como se requiera, solo es necesario agregar más nodos a la configuración.

¿La Disponibilidad es importante?

El tema de la disponibilidad se subestima en la vida real, esto es un error. La disponibilidad de nuestros datos debe ser un tema de mucha importancia, podemos establecer la disponibilidad como un “todo”, a esto le llamaremos: La disponibilidad del Sistema.

La disponibilidad del sistema puede ser definido como el producto de la disponibilidad de cada componente que está dentro de nuestro sistema.

DS=DC1*DC2*DC3*….*DCn

Donde:            DS=Probabilidad de Disponibilidad del Sistema
                        DC1=Probabilidad de Disponibilidad del Componente 1
                        DCn=Probabilidad de Disponibilidad del Componente N

Por ejemplo, si tuviéramos los siguientes componentes:

  • Servidor Web
  • Servidor de aplicaciones
  • Servidor de base de datos

Y cada uno de los anteriores componentes tuviera una disponibilidad del 99%, entonces se espera que la Disponibilidad del Sistema (DS) sea la siguiente:

DS=0.99*0.99*0.99=0.97=97%

Si usted considera que su empresa puede tolerar un sistema con disponibilidad del 97%, está bien. Sin embargo, debe tomar en cuenta que el 97% de Disponibilidad es 11 días al año. ¿Acepta su empresa 11 días al año sin servicio?

Existen dos maneras de mejorar la disponibilidad de nuestro sistema:

1.    Desacoplar componentes: Para tener componentes aislados dentro de nuestro sistema, de tal manera que si un componente falla no afecte a los demás y en consecuencia… no afecte el sistema.

Coherence logra tener componentes desacoplados introduciendo el concepto de operaciones asincrónicas. Esto permite que aunque la capa de datos este inaccesible coherence seguirá aceptando operaciones de lectura/escritura. Las escrituras las irá encolando de tal manera que cuando la capa de datos este nuevamente disponible se realicen las operaciones sobre ella. Esto trae como beneficio que una falla de Base de datos sea totalmente transparente al usuario final.

Sin embargo, hay que tomar en cuenta los siguientes puntos:

·        Muchas aplicaciones utilizando una misma base de datos puede provocar conflictos. Al tener las escrituras de manera asíncronas puede haber conflictos entre las escrituras de las demás aplicaciones. 

·        Cada vez que un usuario necesite consultar datos “viejos”, se debe realizar el refrescado de estos elementos de manera síncrona, lo cual agrega un pequeño costo a la lectura.

·       Si toda la configuración de coherence se cae, las operaciones asíncronas encoladas se perderán pues todo está en memoria. Entiéndase “toda” la configuración como todas las maquinas virtuales de java en todos los servidores involucrados en la configuración de coherence, incluido sus backups. Esto es poco probable, sin embargo, es necesario dejarlo claro.

2.       Redundancia en los componentes: Si usted quiere alcanzar una alta disponibilidad de manera síncrona, la única alternativa es aumentar la redundancia de los componentes.

Sin embargo, la redundancia no es suficiente para lograr una disponibilidad del 100%. Para comprobar esto calculemos la probabilidad de falla de todo un conjunto de componentes redundantes:

FCC=FC1*FC2*…*FCN.

Donde      FCC=Probabilidad de Falla del Conjunto de Componentes redundantes.
                 FC1=Probabilidad de Falla del Componente 1.
                 FCN=Probabilidad de Falla del Componente N.

Haciendo uso del dato “Disponibilidad de un componente” podemos calcular su probabilidad de Falla:

FC=1-DC

Donde      FC=Probabilidad de Falla de un Componente.
                 DC=Probabilidad de Disponibilidad de un Componente.

Por ejemplo, nuestro componente Servidor de Aplicaciones tiene una disponibilidad del 99% entonces su Probabilidad de Falla es:

FC=1-0.99=0.01

Si a este componente le agregamos un Servidor de Aplicaciones de tal manera que nuestro componente ahora sea redundante, tendríamos la siguiente probabilidad de Disponibilidad:

DC=1-(0.01*0.01)=1-0.0001=0.9999=99.99%

Si a cada uno de los 2 componentes restantes que tenemos en nuestro Sistema (Servidor Web y Servidor de Bases de Datos) le agregamos un servidor de tal manera que sean ahora redundantes, la disponibilidad de cada componente quedaría de la siguiente manera:

·         Servidor Web                        =          99.99%
·         Servidor de Aplicaciones     =          99.99%
·         Servidor de Base de Datos  =          99.99%

Entonces la disponibilidad de todo nuestro Sistema quedaría de la siguiente manera:

DS=0.9999*0.9999*0.9999=0.9997=99.97%

Y la probabilidad de falla de todo nuestro Sistema quedaría así:

FS=1-0.9997=0.0003=0.03%

CONCLUSION:

·         Sin redundancia, nuestro sistema tendría 11 días sin servicio al año.
·         Con redundancia, (un componente más) nuestro sistema tiene solamente 2.6 horas al año.

Reformulo mi pregunta anterior: ¿Acepta su empresa 2.6 horas al año sin servicio?

2.6 horas al año sin servido es un dato relativamente aceptable, sin embargo ¡no es 100% de Disponibilidad!

Por intuición vemos que el 100% de Disponibilidad lo vamos alcanzando proporcionalmente a la redundancia que se le dé a cada componente, pero ahí ya tendríamos que involucrar el factor costo. ¿Existe alguna alternativa que nos elimine la necesidad de compra de N componente redundantes? ¡Sí, Oracle Coherence!
           
Arquitectura de Oracle Coherence:

Oracle Coherece trabaja con una arquitectura de “Cluster”.

Esta definición ya es muy conocida, sin embargo, a continuación expongo la definición formal:

Cluster: Es un conjunto de componentes interconectados entre sí trabajando como uno solo.

Un cluster de Oracle Coherence está formado por varios “servidores coherence” que no son más que instancias de maquinas virtuales java las cuales trabajan interconectadas entre sí para formar un solo componente: El cache de Coherence.

Cada una de estos servidores puede alojar datos de varias maneras las cuales dependen de los siguientes principales factores:

  • ¿Sus aplicaciones realizan muchas lecturas?
  • ¿Sus aplicaciones realizan muchas escrituras?
  • ¿Sus aplicaciones toleran leer datos que no están a la fecha?
  • ¿Sus aplicaciones necesitan tener los datos altamente seguros?
  • ¿Es muy grande la cantidad de datos que manejan sus aplicaciones?
  • ¿Utiliza SUN JDK u Oracle Jrockit?

Dependiendo de las respuestas que se les dé a cada una de las anteriores preguntas se puede elegir entre  las siguientes topologías  básicas de Coherence:

NOTA: las 3 topologías presentadas a continuación no son las únicas de las cuales dispone Oracle Coherence, las topologías son muy personalizables.
  1. Topología de Replicación
  2. Topología Particionada
  3. Near-Cache
En la siguiente parte del articulo “Topologías de Coherence Parte 2” estaré tratando la topología de Replicación, ventajas y desventajas.

Parte 2: Topologias de Coherence Parte 2.

Articulo Completo listo para descargarse en el siguiente link: https://www.dropbox.com/s/7dv1aom6u1lzqan/Topologias%20de%20Coherence.pdf

Oracle ACE Director Award - Deiby Gómez

Thanks #OracleACE Program for this awesome certificate recognizing the work I have done in the community for the last year. Looking forwa...